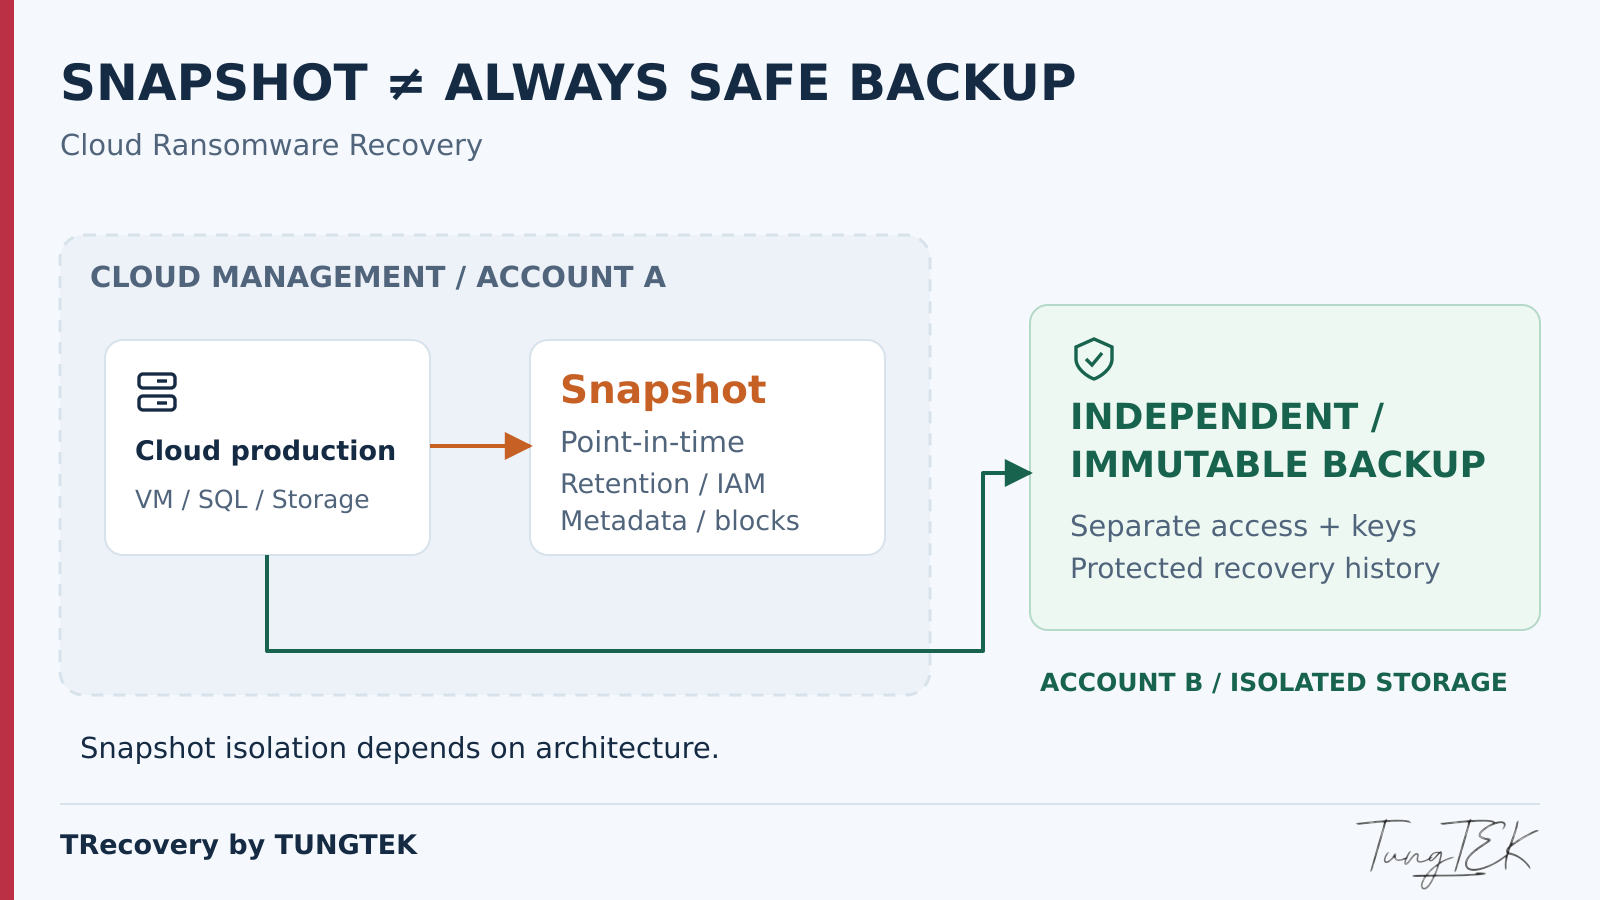
1. Sự cố IDCF Cloud và câu hỏi về khả năng phục hồi
Thông báo ngày 08/10/2026 của IDC Frontier xác nhận ransomware ảnh hưởng 495 doanh nghiệp và cơ quan chính quyền địa phương sử dụng một phần East Japan Region 1. Hãng đánh giá việc trích xuất hoặc khôi phục dữ liệu tại các vùng bị ảnh hưởng là khó khăn; theo nhận định tại thời điểm thông báo, phục hồi chỉ khả thi từ backup khách hàng tự giữ. Đây là tình trạng được công bố, chưa phải kết luận rằng mọi bản sao đều bị phá hủy. [1]
Ba câu hỏi cần tách biệt: dịch vụ có hoạt động không; bản sao dữ liệu có còn không; doanh nghiệp có đưa ứng dụng trở lại được không? High Availability giảm gián đoạn khi thành phần hỏng, nhưng không tự cung cấp lịch sử dữ liệu sạch sau một thay đổi độc hại.
Góc nhìn TRecovery: hãy kiểm kê nguồn phục hồi nằm ngoài phạm vi sự cố trước khi tính thời gian dựng lại máy chủ.
2. Snapshot hoạt động như thế nào?
Point-in-time snapshot ghi nhận trạng thái dữ liệu tại một thời điểm. Trạng thái này thường được mô tả bằng metadata và các block cần thiết, thay vì lập tức nhân đôi toàn bộ ổ đĩa.
Copy-on-write và redirect-on-write
Ở mức khái niệm, copy-on-write giữ lại nội dung cũ của block trước khi cho phép ghi thay đổi; redirect-on-write đưa dữ liệu mới sang vị trí khác, giữ tham chiếu đến trạng thái cũ. Đọc snapshot cần giải quyết đúng các tham chiếu. Cơ chế thực tế tùy filesystem, storage hoặc hypervisor; không được suy ra thiết kế IDCF từ hai khái niệm này.
Snapshot volume khác snapshot VM
Block storage snapshot tập trung vào nội dung volume. VM snapshot có thể liên quan cấu hình, nhiều đĩa và tùy chọn trạng thái bộ nhớ. Riêng snapshot VMware vSphere thường cần đĩa gốc và chuỗi delta; Broadcom cảnh báo delta một mình không đủ dựng VM khi đĩa gốc đã mất. [10]
Metadata hỏng có thể làm dữ liệu còn trên storage nhưng khó truy xuất. Retention quá ngắn có thể xóa điểm sạch trước khi phát hiện sự cố. Tài khoản quản trị có quyền xóa snapshot có thể làm mất cả lịch sử phục hồi. Vì vậy, số lượng snapshot trên màn hình quản trị chưa đủ đánh giá khả năng sống sót.
TRecovery khuyến nghị: ghi lại loại snapshot, nơi chứa block, chuỗi phụ thuộc, thời hạn lưu và người có quyền xóa; kiểm thử phục hồi khi hệ thống nguồn không còn dùng được.
3. Snapshot có phải Backup?
Có thể tham gia vào chiến lược backup, nhưng không phải mọi snapshot đều là backup độc lập. Điều cần kiểm chứng là nguồn phục hồi có tồn tại và dùng được sau những tình huống mà doanh nghiệp muốn chống chịu hay không.
Đọc đúng tài liệu từng nền tảng
IDC Frontier mô tả snapshot lưu trạng thái volume trên thiết bị vật lý khác volume nguồn; hãng cũng nêu đây không phải chức năng lưu trữ dài hạn, dù snapshot định kỳ có thể dùng cho backup. Dịch vụ Backup riêng công bố nơi lưu khác địa điểm và tùy chọn immutable storage. Những mô tả sản phẩm này không chứng minh khách hàng IDCF bị ảnh hưởng đã mua, cấu hình hoặc mất từng dịch vụ đó. [2] [3]
AWS gọi EBS snapshot là incremental backup, lưu trong hạ tầng S3 do AWS quản lý, với đủ thông tin để dựng volume tại thời điểm chụp. Azure Backup có quy trình tạo snapshot rồi chuyển dữ liệu vào vault. Bởi vậy, không thể lấy giới hạn của một snapshot VM để kết luận cho tất cả Cloud snapshot. [5] [7]
Sáu điều kiện cần kiểm chứng
- Truy xuất: lấy được bản sao khi nguồn hoặc console chính gián đoạn.
- Toàn vẹn: đủ block, metadata và thành phần ứng dụng.
- Cô lập: tránh cùng miền lỗi vật lý, tài khoản và mạng.
- Chống xóa: retention, versioning và khóa bảo vệ thực sự có hiệu lực.
- Khóa mã hóa: còn khóa và quyền dùng khóa khi cần restore.
- Phục hồi sạch: đã dựng thử trên môi trường độc lập.
4. Snapshot vs Backup vs Replication
Ba công cụ bổ sung cho nhau. Replication duy trì một bản dữ liệu cập nhật ở nơi khác, nhưng có thể truyền cả thay đổi độc hại. Backup ưu tiên lịch sử phục hồi; snapshot ưu tiên trạng thái tại thời điểm chụp. Mức bảo vệ phụ thuộc kiến trúc.
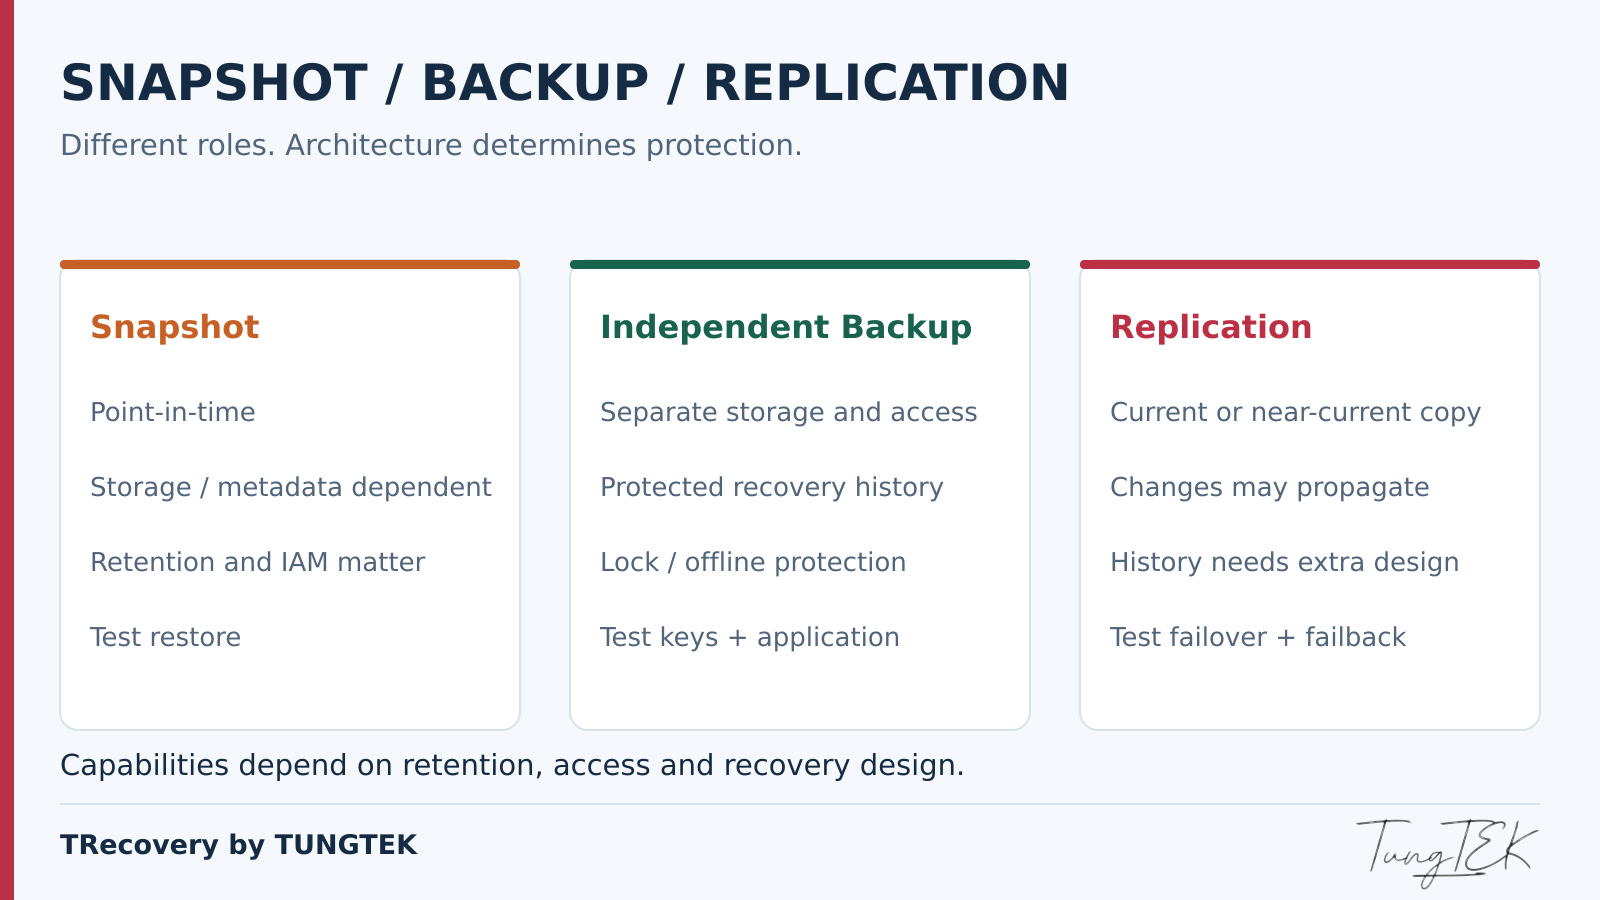
| Tiêu chí | Snapshot | Backup độc lập | Replication |
|---|---|---|---|
| Độc lập với nguồn | Tùy nơi lưu và chuỗi phụ thuộc. | Cần thiết kế riêng dữ liệu, quyền và khóa. | Có thể khác nơi; vẫn phụ thuộc cơ chế đồng bộ. |
| Điểm phục hồi cũ | Theo retention còn giữ. | Theo lịch sử và catalog còn hợp lệ. | Cần versioning hoặc journal nếu muốn quay lại. |
| Phạm vi quyền | Thường qua quyền Cloud/storage. | Nên tách tài khoản vận hành và xóa. | Cần kiểm tra cả nguồn, đích và tài khoản đồng bộ. |
| Chống ransomware xóa | Cần cơ chế lock phù hợp. | Cần immutability đã khóa hoặc bản offline. | Đồng bộ thông thường không tự chống xóa. |
| Tốc độ phục hồi | Có thể nhanh khi phụ thuộc còn sẵn. | Tùy dung lượng, đường truyền và phương thức restore. | Failover có thể nhanh; dữ liệu đích phải sạch. |
| Mất control plane | Cần đường truy xuất thay thế. | Cần catalog, khóa và môi trường phục hồi độc lập. | Cần quyền điều khiển đích độc lập. |
| Diễn tập | Thử dựng từ điểm sạch. | Thử toàn chuỗi và ứng dụng. | Thử failover, dữ liệu và failback. |
TRecovery lưu ý: một bản replicate đã nhận file mã hóa không trở thành điểm phục hồi sạch chỉ vì nó nằm ở datacenter thứ hai.
5. Ransomware tấn công Cloud ở những lớp nào?
Đây là mô hình kịch bản tổng quát của TRecovery, không phải đường xâm nhập hay sơ đồ hạ tầng đã xác minh của IDCF.
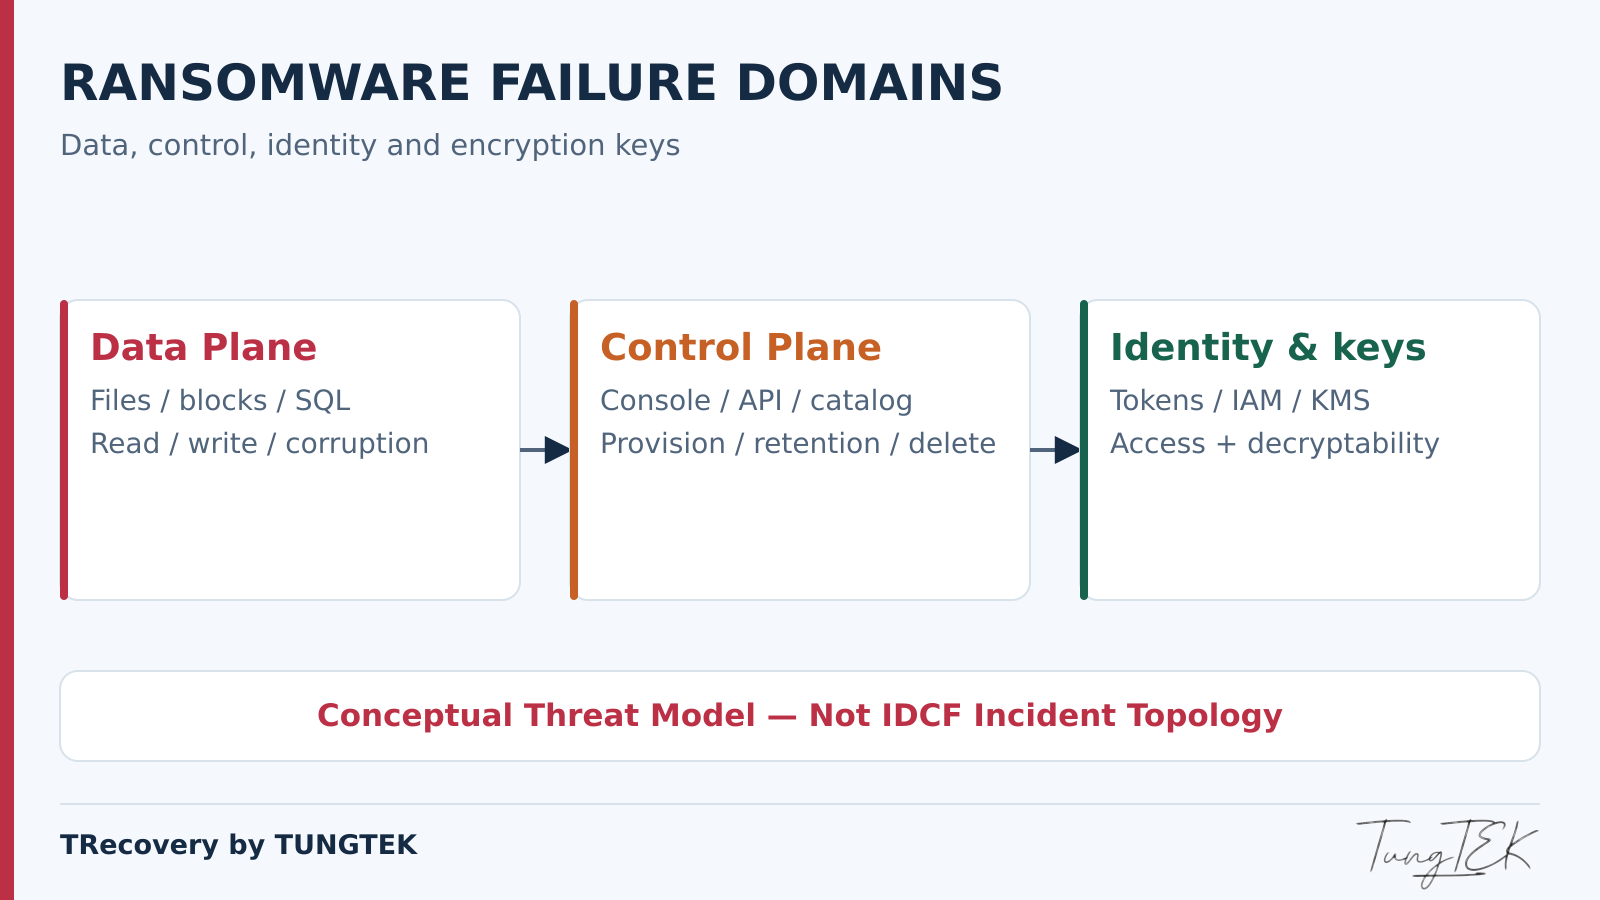
Data Plane — nơi đọc và ghi dữ liệu
File, database hoặc đĩa VM có thể bị mã hóa, xóa hay ghi đè. Snapshot trước thời điểm bị thay đổi chỉ hữu ích nếu các block và đường truy xuất còn nguyên.
Control Plane — nơi điều khiển tài nguyên
Console, API, catalog và policy quản lý việc tạo/xóa volume, backup hoặc điểm phục hồi. Dữ liệu chưa bị mã hóa vẫn có thể không dùng được khi lớp điều khiển mất khả năng phục vụ.
Identity & Key Management — quyền và khóa
Token bị chiếm có thể mở rộng quyền xóa; khóa mã hóa bị mất hoặc vô hiệu hóa có thể chặn restore. Tách storage nhưng dùng chung một tài khoản toàn quyền chưa tách được rủi ro quản trị.
Cần bảo vệ cả ba lớp, đồng thời có quy trình truy cập khẩn cấp được lưu và kiểm thử bên ngoài môi trường sản xuất.
6. Ba kịch bản phục hồi dữ liệu
Các ví dụ sau là tình huống giả định để lập kế hoạch, không phải kết quả xử lý khách hàng hoặc diễn biến IDCF.
A. VM bị ransomware nhưng còn snapshot sạch
Giữ hiện trạng VM bị ảnh hưởng, chọn snapshot trước dấu hiệu xâm nhập và dựng bản sao trong mạng cô lập. Kiểm tra log, tài khoản, persistence và dữ liệu ứng dụng. Một snapshot trước thời điểm mã hóa vẫn có thể chứa tác nhân đã nằm vùng; chỉ quay lại ngày cũ chưa đủ chứng minh môi trường sạch.
Điều kiện thành công: snapshot đọc được, đĩa phụ thuộc còn đủ, ứng dụng nhất quán và có cách dựng bản sao mà không ghi đè nguồn.
B. Mất control plane hoặc khả năng truy cập storage
Xác nhận cùng nhà cung cấp tài nguyên nào còn tồn tại, phương thức export được hỗ trợ và phạm vi thao tác cho phép. Nếu console không hoạt động, có thể cần kênh hỗ trợ hoặc API được phục hồi. Không mặc định một tên volume trong danh mục đồng nghĩa toàn bộ dữ liệu đã sẵn sàng để đọc.
Khi chưa có đường truy xuất an toàn, phải ưu tiên nguồn ngoài môi trường đó; thời gian chờ hạ tầng trở lại là một phần rủi ro RTO.
C. Có backup độc lập, được bảo vệ và kiểm thử
Dựng môi trường sạch, nạp catalog và khóa cần thiết, rồi restore theo runbook đã diễn tập. Đối chiếu dữ liệu với nghiệp vụ trước khi mở kết nối. Độc lập cần bao gồm quyền, khóa và đường phục hồi, thay vì chỉ một địa chỉ lưu trữ khác.
7. SQL Server, BRAVO, FAST, MISA và dữ liệu doanh nghiệp
Không phải mọi phiên bản hoặc cách triển khai BRAVO, FAST, MISA đều dùng cùng kiến trúc database. Trước hết xác định hệ quản trị, phiên bản, recovery model và tài liệu của nhà cung cấp ứng dụng. Phần dưới áp dụng cho hệ thống thực sự chạy SQL Server.
MDF/NDF/LDF và các loại backup
MDF là file dữ liệu chính; NDF là file dữ liệu bổ sung; LDF chứa transaction log. Database còn có thể phụ thuộc FILESTREAM hoặc thành phần khác. Copy một MDF đang mở không tự tạo bộ backup nhất quán. [13]
Full backup là cơ sở phục hồi. Differential giữ thay đổi kể từ full backup làm nền; không phải kể từ differential trước. Transaction log backup giúp nối chuỗi giao dịch theo recovery model phù hợp. File LDF và file log backup TRN là hai đối tượng khác nhau. [11]
Crash-consistent và application-consistent
Crash-consistent giống trạng thái đĩa khi máy đột ngột mất điện: ứng dụng phải dùng cơ chế recovery của mình và các thành phần cần khớp thời điểm. Application-consistent có sự phối hợp với ứng dụng. Trên Windows, Azure Backup sử dụng VSS trong quy trình snapshot nhất quán ứng dụng. [7]
Góc nhìn TRecovery: hãy kiểm tra SQL VSS Writer và kết quả job thực tế, thay vì chỉ tin nhãn “VM backup successful”. Nếu MDF và LDF nằm ở volume khác nhau, việc chụp riêng rẽ có thể không đáp ứng tính nhất quán mong muốn.
Restore chain và kiểm tra dữ liệu
Phục hồi theo thời điểm cần full backup phù hợp, differential nếu sử dụng, rồi log backup liên tục theo thứ tự đến thời điểm đích. Các bước trung gian giữ trạng thái NORECOVERY; STOPAT được áp dụng phù hợp khi restore log. Thiếu một đoạn cần thiết có thể giới hạn điểm phục hồi. [9]
Trên bản restore cô lập, chạy kiểm tra integrity và thử nghiệp vụ: đăng nhập, đối chiếu chứng từ, công nợ, tồn kho và kỳ kế toán. RESTORE VERIFYONLY không thay thế restore thật hoặc kiểm tra cấu trúc database. [14]
DBCC CHECKDB kiểm tra tính toàn vẹn logic và vật lý. Tùy chọn repair có thể làm mất dữ liệu; cần giữ bản sao nguồn trước khi cân nhắc can thiệp. [12] Trích xuất được bảng và phục hồi ERP sử dụng được là hai mức kết quả cần nghiệm thu riêng.
8. Kiến trúc Backup 3-2-1-1-0
Veeam mô tả 3-2-1-1-0 như phần mở rộng của quy tắc 3-2-1, bổ sung bản offline/air-gapped hoặc immutable và kiểm chứng phục hồi. Đây là nguyên tắc thiết kế, không phải chứng nhận rằng mọi cấu hình mang nhãn này đều an toàn. [15]
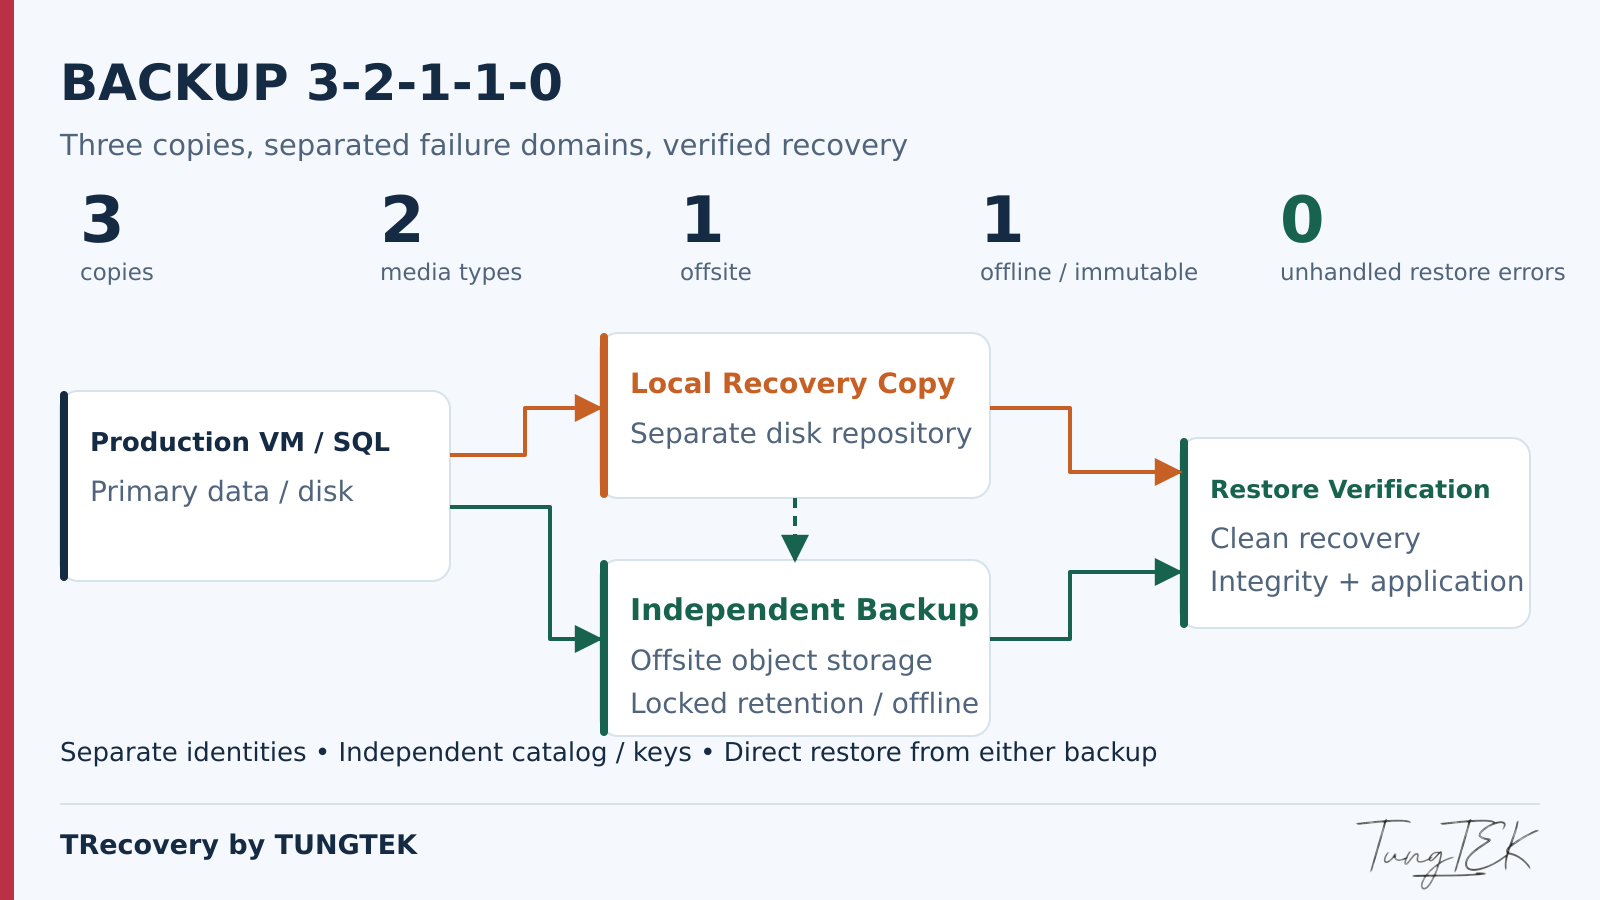
- 3 — Ba bản dữ liệu
- Một bản production và ít nhất hai bản backup.
- 2 — Hai loại media
- Ví dụ disk repository và object storage; xem xét thêm miền lỗi độc lập.
- 1 — Một bản ngoài địa điểm
- Tách khỏi sự cố ảnh hưởng địa điểm chính.
- 1 — Một bản offline hoặc immutable
- Bảo vệ bản sao trước thay đổi và xóa trái phép.
- 0 — Không còn lỗi phục hồi chưa xử lý
- Kiểm chứng bằng restore, integrity và ứng dụng; không hứa rủi ro bằng không.
Ví dụ triển khai cho SME Việt Nam
Production chạy VM/SQL; repository riêng giữ bản phục hồi nhanh; backup được sao sang object storage ngoài địa điểm với tài khoản riêng. Một bản được khóa retention hoặc luân phiên ra thiết bị offline. Kho đích vẫn đọc được khi repository nội bộ ngừng hoạt động; catalog, khóa và runbook có bản độc lập.
Tài khoản production không có quyền xóa kho backup. Phân vùng mạng và giới hạn cổng quản trị; dùng MFA và quyền tối thiểu. Thử phục hồi khi mất tài khoản vận hành thông thường để phát hiện phụ thuộc ẩn.
Immutable cần đúng trạng thái khóa: AWS phân biệt governance và compliance; Azure cũng phân biệt bật immutability với khóa cấu hình. Phải kiểm tra hiệu lực thực tế, không chỉ thấy một công tắc đã bật. [6] [8]
9. RPO/RTO và lịch backup tham khảo
RPO là mức mất dữ liệu theo thời gian có thể chấp nhận; RTO là thời gian mục tiêu đưa dịch vụ trở lại. Ban lãnh đạo cần chốt hai mục tiêu theo nghiệp vụ, rồi IT đo khả năng đáp ứng.
| Tác vụ | Lịch minh họa | Điều phải đo |
|---|---|---|
| Full backup | Hằng đêm | Thời gian restore nền và khả năng đọc. |
| Differential | Mỗi 4 giờ | Đúng full base, thời gian nạp. |
| Log backup | Mỗi 15 phút | Chuỗi liên tục và bản sao đã tới kho bảo vệ. |
| Restore verification | Mẫu hằng tuần; toàn hệ thống theo quý | Integrity, nghiệp vụ và tổng thời gian phục hồi. |
Lịch này là điểm xuất phát, không phải cam kết. Nếu log mới nhất chưa tới kho độc lập hoặc điểm sạch lùi xa hơn, RPO thực tế có thể lớn hơn 15 phút. Dựng máy, tải backup, mở khóa, restore và kiểm tra ứng dụng đều tính vào RTO. Cần điều chỉnh theo dung lượng, băng thông và kết quả diễn tập.
10. Quy trình ứng phó Cloud Ransomware
CISA khuyến nghị giữ backup offline, mã hóa và kiểm thử định kỳ. Trong xử lý sự cố, TRecovery chuyển các nguyên tắc bảo toàn và phục hồi thành quy trình dưới đây. [4]
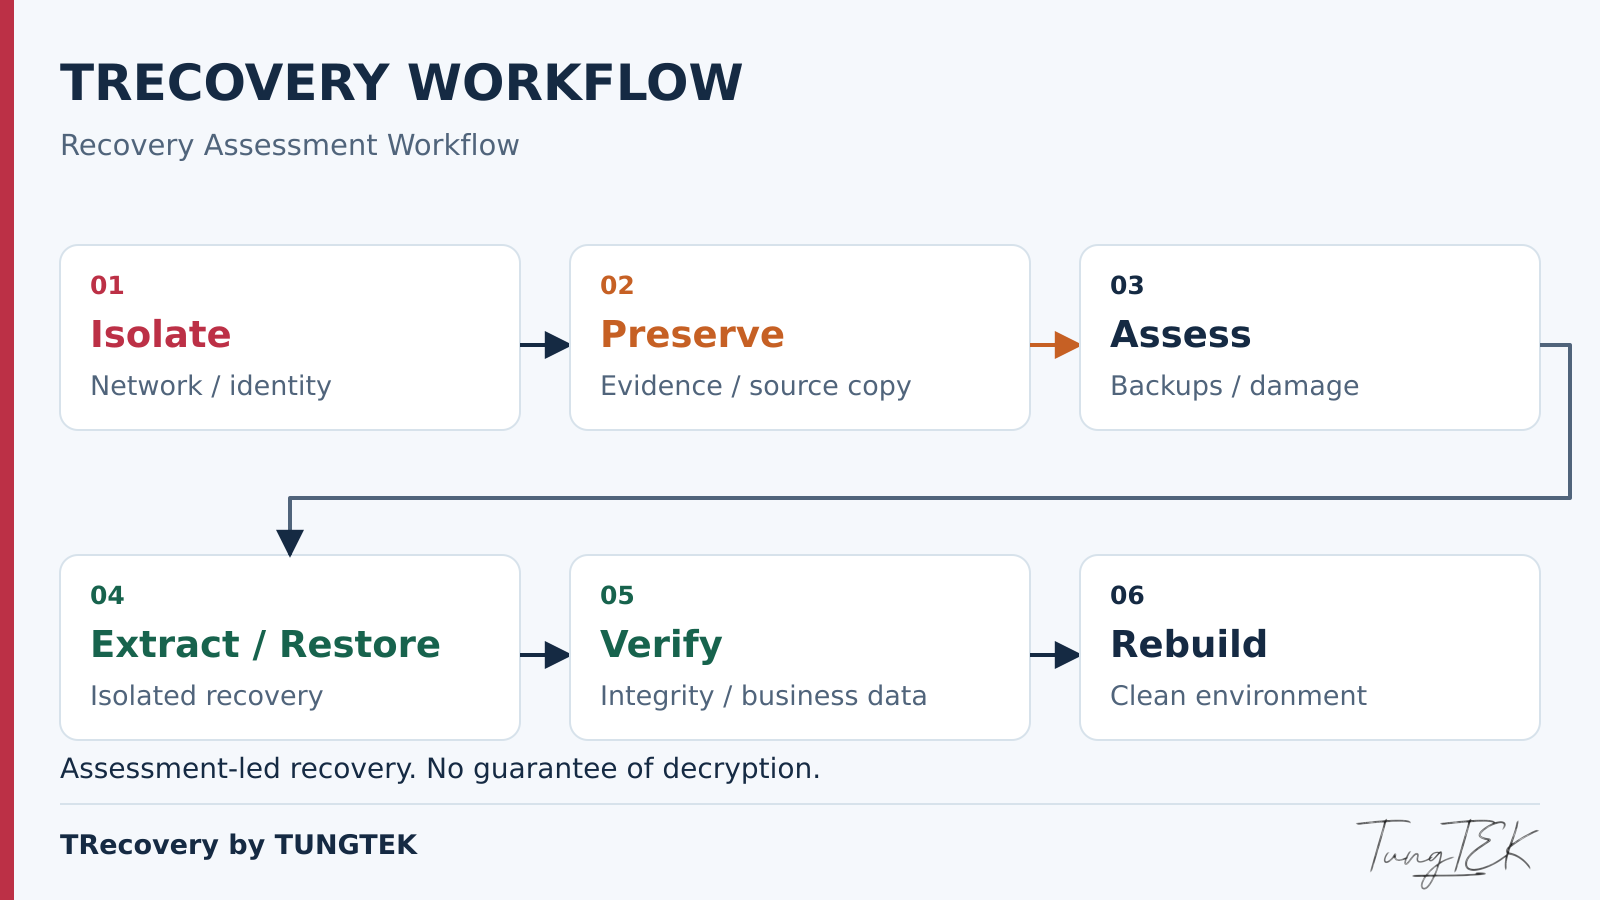
- Cô lập: chặn kết nối và thông tin xác thực nghi bị chiếm theo kế hoạch ứng phó. Phối hợp nhà cung cấp nếu tài nguyên thuộc hạ tầng họ quản lý.
- Bảo toàn chứng cứ: giữ log, timeline, cấu hình, thông báo và định danh tài nguyên. Thu thập volatile evidence khi phù hợp và khả thi; lập bản sao hoặc image được hỗ trợ trước khi can thiệp.
- Kiểm tra backup: kiểm kê cả bản local, offsite, immutable, offline; xác nhận đường đọc, catalog và khóa. Không mở bản gốc cho môi trường nghi nhiễm.
- Chọn điểm sạch: đối chiếu lịch sử xâm nhập, retention và tính nhất quán, thay vì chọn mặc định bản mới nhất.
- Trích xuất an toàn: làm việc trên bản sao; ghi lại công cụ, nguồn và phạm vi, giữ checksum khi phù hợp.
- Restore cô lập: dùng máy chủ và tài khoản sạch, giới hạn kết nối; kiểm tra mã độc và cấu hình trước khi mở dịch vụ.
- Kiểm tra dữ liệu: đối chiếu file, database, nghiệp vụ và phần còn thiếu; ghi nhận giới hạn bằng văn bản.
- Tái triển khai: xử lý nguyên nhân, thay bí mật xác thực, vá hệ thống và xác nhận backup mới trước khi vận hành.
11. Không có Backup thì còn cứu được dữ liệu không?
Không có backup làm giảm lựa chọn, nhưng chưa đủ để kết luận dữ liệu đã mất hoàn toàn. Cần phân loại hiện trạng trên chứng cứ và mẫu đại diện.
- Dữ liệu còn, mất quyền truy cập: có thể cần khôi phục quyền hoặc đường export được hỗ trợ; không đồng nghĩa cần giải mã.
- Metadata/volume hỏng: đánh giá cấu trúc lưu trữ và khả năng đọc trên bản sao, tùy quyền truy xuất hạ tầng.
- Mã hóa một phần: kiểm tra vùng còn nguyên, cấu trúc file và quan hệ dữ liệu; phần trăm byte còn lại không bằng phần trăm ứng dụng phục hồi được.
- Mã hóa mạnh, không có khóa: khi triển khai mật mã đúng và không còn nguồn khác, thường không có phương án phục hồi thực tế từ ciphertext.
- Database thiếu thành phần nhất quán: có thể trích xuất một phần nhưng chưa dựng được database hoặc ERP hoàn chỉnh.
Bản export báo cáo, máy trạm và hệ thống tích hợp có thể giữ dữ liệu bổ sung. Chúng cần kiểm tra nguồn gốc, thời điểm và mức đầy đủ. Không cam kết tỷ lệ phục hồi khi chưa đánh giá, và không ghi đè nguồn chỉ để thử một khả năng.
Xem thêm phân tích IronChain và giới hạn phục hồi hoặc Ransomware Fast Check (RFC) để hiểu bước đánh giá hiện trạng.
12. Góc nhìn TRecovery: Đừng đánh đồng mất Cloud với mất hoàn toàn dữ liệu
Đây là góc nhìn kỹ thuật của TRecovery by TUNGTEK, không phải kết quả giám định trực tiếp vụ IDCF Cloud. Trước khi quyết định phương án, đội ngũ Recovery cần trả lời bốn câu hỏi:
- Dữ liệu còn tồn tại ở những nguồn nào?
- Dữ liệu bị mã hóa hay mất khả năng truy cập?
- Có thể trích xuất mà không làm thay đổi dữ liệu nguồn không?
- Dữ liệu đã trích xuất có đủ khả năng phục hồi thành ứng dụng sử dụng được không?
Việc đầu tiên sau một sự cố ransomware không nên là ghi đè, khởi tạo lại volume hoặc thử khôi phục tùy tiện. Cần bảo toàn nguồn dữ liệu, xác định hiện trạng và đánh giá khả năng phục hồi trước khi triển khai phương án xử lý.
Khuyến nghị kỹ thuật — TRecovery by TUNGTEK
13. Mười câu hỏi tự kiểm tra cho doanh nghiệp
Dùng checklist trong buổi rà soát với IT và người phụ trách nghiệp vụ. Mỗi câu trả lời cần một bằng chứng, người chịu trách nhiệm và việc sửa nếu chưa đạt.
- Nguồn: đã kiểm kê database, volume, file cấu hình và phụ thuộc ứng dụng chưa?
- Độc lập: mất production hoặc console chính, còn lấy được backup không?
- Quyền: tài khoản production có xóa được mọi bản sao không?
- Retention: còn điểm phục hồi trước thời gian nghi xâm nhập không?
- Chống xóa: immutability đã khóa hoặc bản offline đã tách thật chưa?
- Khóa: lấy được khóa/certificate khi mất máy chủ hoặc tài khoản chính không?
- Nhất quán: snapshot/backup có bao quát đủ volume và ứng dụng không?
- SQL: full base, differential và chuỗi log cần dùng còn liên tục không?
- Diễn tập: lần restore gần nhất có kiểm tra integrity và nghiệp vụ không?
- Vận hành: RPO/RTO đo được là bao nhiêu, ai quyết định đưa dịch vụ trở lại?
Câu trả lời “chưa thử” là một khoảng trống cần xử lý.
14. Kết luận: Đánh giá backup bằng khả năng phục hồi
Snapshot có thể rất hữu ích và có thể là thành phần của Cloud Backup. Mức an toàn phải được chứng minh bằng dữ liệu còn truy xuất được, toàn vẹn, cô lập, chống xóa và restore trên môi trường sạch. Sự cố IDCF đặt lại câu hỏi này cho doanh nghiệp, nhưng không cho phép suy diễn tình trạng từng snapshot hay dịch vụ backup chưa được công bố.
TRECOVERY BY TUNGTEK
Ransomware & Data Recovery
Đội ngũ TRecovery hỗ trợ đánh giá tình trạng dữ liệu, trích xuất dữ liệu mã hóa và xác định phương án phục hồi đối với SQL Server, NAS, RAID, VMware và các hệ thống lưu trữ doanh nghiệp.
🇻🇳 Sự cố dữ liệu? Gọi TUNGTEK.Zalo/Hotline: 0963 509 115Theo dõi tình báo và diễn biến ransomware Việt Nam, quốc tế tại Ransomware.VN.
Nguồn tham khảo
Đối chiếu tài liệu công khai ngày 09/10/2026. Tình trạng sự cố IDCF trong bài dựa trên thông báo 08/10/2026.
- IDC Frontier — Thông báo sự cố lần 3, 08/10/2026
- IDC Frontier — Snapshot: chức năng và phạm vi sử dụng
- IDC Frontier — Dịch vụ Backup và nơi lưu trữ
- CISA — #StopRansomware Guide
- AWS — Amazon EBS snapshots
- AWS — Backup Vault Lock
- Microsoft — Azure Backup architecture
- Microsoft — Azure Backup data protection best practices
- Microsoft — SQL Server point-in-time restore
- Broadcom — VMware snapshot best practices
- Microsoft — Back up and restore SQL Server databases
- Microsoft — DBCC CHECKDB
- Microsoft — Database files and filegroups
- Microsoft — RESTORE VERIFYONLY
- Veeam — 3-2-1 và 3-2-1-1-0
Phân tích, ví dụ và sơ đồ TRecovery là nội dung biên tập độc lập. Không suy diễn tình trạng từng snapshot/backup của IDCF khi chưa có bằng chứng công khai. Không có cam kết tỷ lệ giải mã hoặc phục hồi.